Local LLM Runtime Masuki Generasi Baru, Hardware Lokal Makin Siap Menjalankan Model AI Besar
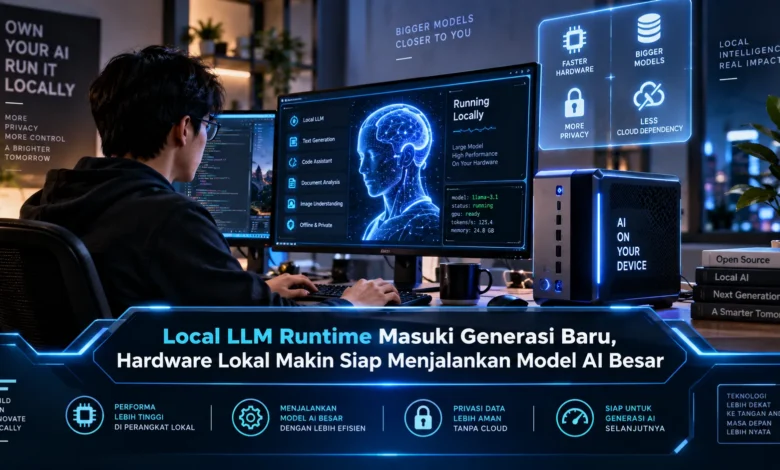
Local LLM Runtime memasuki tahap perkembangan yang semakin menarik seiring meningkatnya kemampuan hardware lokal untuk menangani model AI berukuran lebih besar. Laptop, workstation, mini PC, dan perangkat dengan akselerator AI kini tidak hanya digunakan untuk pekerjaan komputasi biasa, tetapi mulai diarahkan menjadi mesin AI pribadi. Perubahan ini membuat TEKNOLOGI kecerdasan buatan semakin dekat dengan pengguna karena pemrosesan model dapat dilakukan secara lokal dengan kontrol yang lebih besar terhadap performa, data, dan konfigurasi.
Local LLM Runtime Mengubah Perangkat Lokal Menjadi Mesin AI
Generasi baru Local LLM membuat pemrosesan AI semakin fleksibel karena model dapat dijalankan langsung melalui laptop, workstation, maupun mini PC. Sistem runtime membantu model menggunakan prosesor, akselerator grafis, unit pemrosesan AI, dan RAM sesuai kemampuan hardware. Kemampuan ini membawa TEKNOLOGI Local LLM menuju penggunaan yang lebih luas karena sebagian pekerjaan AI dapat diselesaikan langsung di perangkat.
Ekosistem Local LLM berkembang bukan hanya dari sisi hardware tetapi juga melalui software yang semakin mudah digunakan untuk mengelola model. Pengguna dapat menyesuaikan ukuran model, tingkat quantization, panjang konteks, serta penggunaan memori berdasarkan kemampuan perangkat yang dimiliki. Fleksibilitas tersebut membuat TEKNOLOGI AI lokal semakin cocok digunakan oleh pengembang maupun pengguna umum yang membutuhkan asisten AI pribadi.
CPU GPU dan NPU Membuat Hardware Lokal Semakin Siap
Peningkatan kemampuan hardware menjadi salah satu faktor utama yang mendorong Local LLM Runtime semakin berkembang karena pemrosesan model membutuhkan komputasi dan bandwidth memori yang cukup tinggi. CPU tetap dapat menangani berbagai proses AI sementara GPU menawarkan paralelisme tinggi yang sangat membantu komputasi model berukuran besar. Kemajuan hardware membantu TEKNOLOGI AI lokal menjangkau laptop, mini PC, dan workstation dengan tingkat performa berbeda.
NPU juga mulai mendapat perhatian karena komponen ini dirancang untuk mempercepat jenis operasi tertentu yang berkaitan dengan kecerdasan buatan. Efektivitas setiap komponen tetap ditentukan oleh dukungan driver, runtime, dan jenis model yang sedang dijalankan. Integrasi CPU, GPU, dan NPU membuka peluang TEKNOLOGI Local LLM bekerja lebih optimal pada generasi hardware berikutnya.
Kapasitas RAM dan VRAM Menjadi Kunci Menjalankan Model AI Besar
Model bahasa tidak hanya membutuhkan prosesor yang cepat tetapi juga membutuhkan memori yang cukup untuk menyimpan bobot serta data selama pemrosesan. Model dengan jumlah parameter yang lebih besar umumnya membutuhkan kapasitas memori lebih tinggi terutama apabila dijalankan menggunakan presisi yang lebih tinggi. Kondisi tersebut membuat TEKNOLOGI hardware lokal mulai memperhatikan kapasitas memori sebagai bagian penting dari pengalaman menjalankan Local LLM.
Perangkat dengan memori yang lebih besar memberikan ruang untuk menjalankan model lebih kompleks atau menggunakan konteks lebih panjang tanpa terlalu sering memindahkan data. Jumlah memori bukan satu satunya faktor karena kecepatan perpindahan data juga dapat memengaruhi performa inferensi. Performa terbaik membutuhkan kombinasi memori dan komputasi yang seimbang sehingga tidak terjadi hambatan pada salah satu komponen.
Model AI Berukuran Besar Menjadi Lebih Ringan Berkat Quantization
Quantization menjadi salah satu teknik penting dalam perkembangan Local LLM karena metode ini dapat mengurangi kebutuhan memori model dengan menggunakan representasi numerik yang lebih ringkas. Pengurangan kebutuhan memori memberikan peluang bagi perangkat konsumen untuk menjalankan model yang sebelumnya terlalu berat untuk hardware lokal. Efisiensi model membuat TEKNOLOGI Local LLM semakin realistis bagi pengguna yang menggunakan perangkat konsumen modern.
Setiap tingkat optimasi dapat memberikan kompromi berbeda sehingga pengguna perlu menyesuaikannya dengan jenis pekerjaan yang dilakukan. Untuk tugas ringan model dengan optimasi agresif mungkin sudah memadai sementara pekerjaan yang membutuhkan ketelitian lebih tinggi dapat memperoleh manfaat dari konfigurasi yang lebih besar. Pilihan berbagai tingkat optimasi membuat TEKNOLOGI AI lokal lebih fleksibel untuk digunakan pada banyak jenis hardware.
Perangkat Komputasi Lokal Mulai Menjadi Pusat AI
Laptop generasi baru mulai memiliki kombinasi CPU, GPU, NPU, dan RAM yang semakin sesuai untuk berbagai kebutuhan kecerdasan buatan lokal. AI lokal dapat digunakan untuk mendukung berbagai aktivitas produktivitas seperti penulisan, pengolahan teks, pencarian informasi, serta coding. Integrasi AI lokal membuat TEKNOLOGI komputer pribadi semakin mampu menyediakan kemampuan kecerdasan buatan secara mandiri.
Perangkat desktop ringkas maupun workstation berperforma tinggi dapat digunakan sebagai server AI pribadi untuk menjalankan model secara lokal. Pengguna dapat menempatkan model pada satu sistem lalu mengaksesnya dari komputer lain melalui jaringan lokal sesuai konfigurasi yang dibuat. Pendekatan server pribadi memberikan TEKNOLOGI AI lokal pilihan arsitektur baru yang dapat disesuaikan dengan kebutuhan pengguna.
Privasi dan Kontrol Data Menjadi Nilai Tambah Local LLM
Pemrosesan lokal menawarkan keuntungan penting karena data dapat tetap berada pada perangkat selama aplikasi dan runtime tidak mengirimkan informasi tersebut menuju layanan eksternal. Dokumen pribadi, catatan pekerjaan, kode program, maupun data internal dapat dianalisis tanpa harus selalu mengunggah seluruh konten ke server jarak jauh. Pendekatan tersebut membuat TEKNOLOGI Local LLM semakin relevan bagi penggunaan yang membutuhkan kontrol lebih besar terhadap lokasi pemrosesan data.
Walaupun demikian pemrosesan lokal tidak berarti keamanan otomatis terjamin karena pengguna tetap perlu menjaga sistem operasi, runtime, model, dan aplikasi pendukung. Runtime dan model sebaiknya diperoleh dari sumber terpercaya sementara pembaruan keamanan perangkat perlu dipasang secara berkala. Pendekatan yang seimbang membantu TEKNOLOGI AI lokal menawarkan privasi sekaligus mempertahankan perlindungan sistem.
Kesimpulan Hardware Lokal yang Semakin Siap Menjalankan Model AI Besar
Local LLM Runtime memasuki generasi baru karena perkembangan hardware membuat semakin banyak perangkat mampu menjalankan model AI dengan ukuran dan kemampuan yang lebih besar. Kemampuan menjalankan model besar ditentukan oleh keseimbangan antara TEKNOLOGI hardware dan optimasi software yang digunakan. Perangkat lokal yang semakin kuat membuka peluang TEKNOLOGI AI digunakan untuk lebih banyak aktivitas tanpa selalu bergantung pada server eksternal. Privasi dan kontrol data juga menjadi nilai tambahan karena sebagian pemrosesan dapat berlangsung langsung pada perangkat pengguna. Jika perkembangan hardware dan software terus bergerak seimbang, TEKNOLOGI Local LLM berpotensi menjadikan AI lokal sebagai bagian standar dari komputer generasi berikutnya. Pembaca dapat terus mengikuti evolusi TEKNOLOGI Local LLM karena inovasi hardware berikutnya dapat menghadirkan kemampuan AI lokal yang semakin besar.