Nvidia Nemotron 3.5 Transcribe Diperkenalkan untuk Pemrosesan Rekaman Suara Berbasis AI
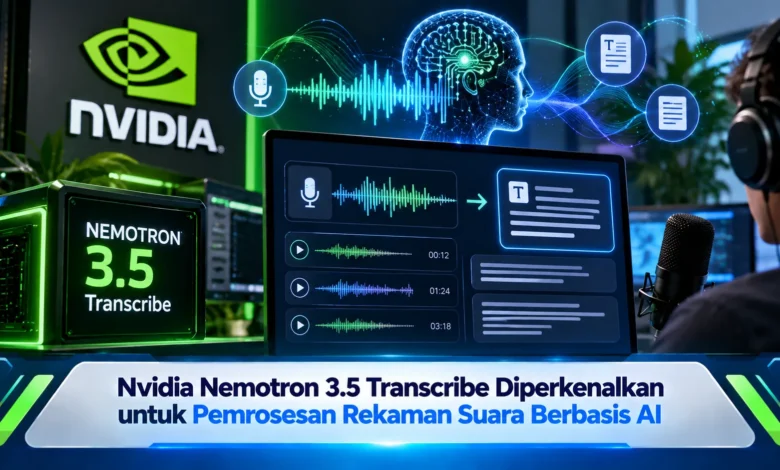
Nvidia memperkenalkan Nemotron 3.5 Transcribe pada 28 Oktober 2026 sebagai model kecerdasan buatan terbuka yang dirancang untuk mengubah rekaman suara menjadi informasi yang lebih mudah digunakan. Teknologi ini mampu mentranskripsikan percakapan dalam 40 bahasa, mengenali pembicara, menerjemahkan ucapan, serta menghasilkan teks berdasarkan instruksi pengguna. Berbeda dari sistem pengenalan suara konvensional, Nemotron 3.5 Transcribe menggabungkan berbagai kemampuan pemrosesan audio dalam satu model. Dengan dukungan rekaman hingga satu jam dan sekitar 4,3 miliar parameter aktif, inovasi tersebut membuka peluang pengembangan aplikasi transkripsi untuk rapat, layanan pelanggan, penelitian, dan kebutuhan dokumentasi profesional.
Nvidia Nemotron 3.5 Transcribe Menghadirkan Inovasi Pemrosesan Audio
Kehadiran Nvidia Nemotron 3.5 Transcribe menandai langkah baru dalam teknologi pengenalan percakapan otomatis. Berkat inovasi yang diperkenalkan, Nvidia menawarkan solusi pengolahan rekaman multibahasa. Jika dibandingkan dengan sistem pengenalan suara yang memiliki fungsi transkripsi terbatas, Nemotron 3.5 Transcribe dirancang untuk menjalankan berbagai tugas audio menggunakan perintah berbentuk percakapan. Pendekatan tersebut memberikan kesempatan kepada pengembang untuk mengatur jenis keluaran sesuai karakteristik rekaman. Berkat fleksibilitas ini, sebuah sistem kecerdasan buatan dapat mendukung analisis percakapan profesional.
Perusahaan teknologi tersebut merancang Nemotron 3.5 Transcribe sebagai teknologi AI yang menyediakan akses bobot model. Model distribusi tersebut memungkinkan pengembang menerapkan sistem pada infrastruktur sendiri berdasarkan kebijakan distribusi yang berlaku. Tidak sama dengan layanan yang hanya tersedia melalui API tertutup, ketersediaan bobot model memperluas pilihan implementasi kepada tim teknologi informasi. Walaupun model dapat diunduh, penerapan pada perangkat lokal tetap membutuhkan perangkat keras yang sesuai. Dengan mempertimbangkan persyaratan tersebut, pemilihan infrastruktur perlu dilakukan secara cermat sebelum membangun aplikasi berbasis Nemotron.
Teknologi Speech Recognition Nvidia Menangani Beragam Percakapan
Fitur penting Nemotron 3.5 Transcribe adalah kemampuan mengenali ucapan dalam 40 bahasa. Dukungan bahasa tersebut memiliki manfaat penting bagi perusahaan dengan pengguna multibahasa. Pada lingkungan kerja modern, materi audio berpotensi memuat percakapan dengan latar bahasa berbeda. Melalui teknologi ini, pengembang dapat membangun aplikasi yang menghasilkan dokumentasi percakapan tanpa selalu memerlukan model berbeda untuk setiap tugas. Tidak hanya itu, model turut menyediakan penerjemahan ucapan antara bahasa Inggris dan sejumlah bahasa lain yang tersedia dalam kemampuan penerjemahannya.
Untuk kebutuhan transkripsi, Nvidia menghadirkan beberapa gaya keluaran. Pengguna dapat meminta hasil tulisan kata demi kata yang mempertahankan kata-kata pembicara. Sebaliknya, model memungkinkan penyusunan hasil dokumentasi yang lebih mudah dibaca. Pada rekaman wawancara, istilah teknis bisa diproses mengikuti format transkripsi yang ditentukan. Kemampuan pengaturan keluaran bermanfaat untuk pengarsipan percakapan dengan kebutuhan format yang berbeda. Kendati hasil dapat dibuat lebih rapi, ketepatan hasil harus ditinjau sebelum digunakan sebagai dokumen resmi.
Teknologi Speaker Diarization Mempermudah Dokumentasi Rapat
Selain menghasilkan transkripsi, Nemotron 3.5 Transcribe memiliki kemampuan speaker diarization, yaitu proses identifikasi pergantian pembicara. Kemampuan ini sangat berguna ketika dokumentasi mencakup diskusi kelompok. Dalam situasi rapat, model berpotensi mengidentifikasi kalimat yang berasal dari suara berbeda. Berkat pengelompokan suara, pengguna lebih mudah mengikuti alur diskusi. Perusahaan turut memperkenalkan kemampuan menangani ucapan yang saling tumpang tindih. Pengembangan tersebut memberikan manfaat tambahan karena rekaman rapat dapat memuat suara yang saling menimpa.
Sebagai pelengkap dokumentasi adalah informasi waktu untuk setiap kata yang mendukung penyelarasan teks dengan audio. Dengan fitur tersebut, pengguna dapat menemukan lokasi ucapan spesifik secara lebih praktis. Pada pengembangan aplikasi, transkrip rapat mampu disinkronkan dengan pemutaran audio agar pengguna dapat memeriksa ucapan terkait. Nvidia menjelaskan bahwa penanda waktu dihasilkan melalui komponen penyelarasan berbasis CTC. Namun demikian, akurasi posisi kata tetap memerlukan evaluasi, terutama jika beberapa suara saling tumpang tindih.
Model Nemotron Memanfaatkan Pemrosesan Bahasa dan Pengenalan Suara
Dalam aspek teknis, Nemotron 3.5 Transcribe mengintegrasikan komponen pengenalan suara dengan model bahasa berukuran besar. Arsitektur ini dikembangkan berdasarkan Nemotron 3.5 Lightning dengan rancangan pemrosesan Mamba-Transformer. Selain itu, Nvidia mengintegrasikan konsep mixture-of-experts yang memilih komponen komputasi tertentu ketika menghasilkan keluaran. Secara keseluruhan, Nemotron 3.5 Transcribe dibangun dengan jumlah parameter keseluruhan sekitar 34 miliar, tetapi jumlah parameter aktifnya berada di kisaran 4,3 miliar selama pengoperasian model. Konfigurasi tersebut berpotensi memperbaiki efisiensi penggunaan sumber daya.
Pada proses pelatihan speech AI, Nvidia menggunakan berbagai jenis data pelatihan agar fitur transkripsi dapat disesuaikan melalui instruksi. Sistem kecerdasan buatan tersebut mendukung penerjemahan ucapan, serta pemisahan pembicara. Melalui evaluasi yang dipublikasikan, Nvidia menyampaikan bahwa model mencatat tingkat kesalahan kata rata-rata 4,71 persen pada sembilan set pengujian publik English Open ASR Leaderboard. Untuk benchmark multibahasa, tingkat kesalahan kata mencapai 4,62 persen. Kendati performa pengujian terlihat kuat, hasil transkripsi penggunaan sehari-hari dapat berbeda menurut kualitas mikrofon dan karakter pembicara.
Pemanfaatan Model Audio Nvidia untuk Rapat dan Layanan Pelanggan
Manfaat praktis teknologi ini adalah penyusunan dokumentasi diskusi. Dalam aktivitas perusahaan, mengidentifikasi hasil diskusi dapat menghabiskan proses peninjauan manual. Melalui Nemotron 3.5 Transcribe, audio pertemuan dapat diubah menjadi teks yang lebih mudah ditinjau. Pengembang juga dapat meminta menampilkan label penutur, menerjemahkan ucapan dan menjawab pertanyaan terkait rekaman. Melalui kombinasi fitur tersebut, organisasi dapat membantu menyederhanakan proses dokumentasi secara lebih praktis.
Selain lingkungan perkantoran, teknologi transkripsi AI berpotensi mendukung layanan pelanggan. Sebagai contoh, audio interaksi layanan mampu dianalisis untuk meninjau isi komunikasi. Dalam aktivitas medis, sistem memiliki kemungkinan digunakan untuk penyusunan transkrip percakapan, dengan kepatuhan terhadap aturan privasi. Pengembang model ini juga mendukung penyesuaian kosakata melalui instruksi yang dirancang mendukung pengenalan nama organisasi. Namun demikian, hasil transkripsi tetap harus diverifikasi, terutama ketika menjadi dasar dokumen hukum.
Kesimpulan: Nemotron 3.5 Transcribe Memperluas Kemampuan AI Suara
Kehadiran Nvidia Nemotron 3.5 Transcribe menandai perkembangan penting dalam pemrosesan bahasa dan suara. Berkat kemampuan menangani 40 bahasa, penandaan penutur, penerjemahan ucapan, model tersebut menawarkan berbagai fungsi dalam satu sistem. Pendekatan open-weight turut menghadirkan kendali tambahan terhadap penerapan bagi pengembang perangkat lunak. Selain itu, penggunaan sekitar 4,3 miliar parameter aktif mendukung pemanfaatan sumber daya komputasi. Meski demikian, kualitas transkripsi tetap perlu disesuaikan berdasarkan kebutuhan penggunaan.
Seiring kemajuan kecerdasan buatan, pemanfaatan model suara berpotensi menjadi bagian penting produktivitas. Model transkripsi terbaru Nvidia berpotensi mendukung pengembangan aplikasi rapat melalui pemrosesan audio yang lebih terstruktur. Namun demikian, organisasi sebaiknya mengevaluasi keamanan penyimpanan data dan keterbatasan pengenalan suara. Dalam implementasi teknis, model ini berfokus pada pemrosesan audio non-streaming, bukan pengenalan suara streaming tanpa jeda. Menurut pengalaman Anda, apakah model transkripsi AI seperti Nemotron akan mempermudah pekerjaan dokumentasi? Silakan bagikan pendapat Anda mengenai perkembangan teknologi speech AI.


