Tips Menjalankan LLM Offline dengan Perangkat Terbatas, Optimalkan Model AI agar Tidak Boros Memori
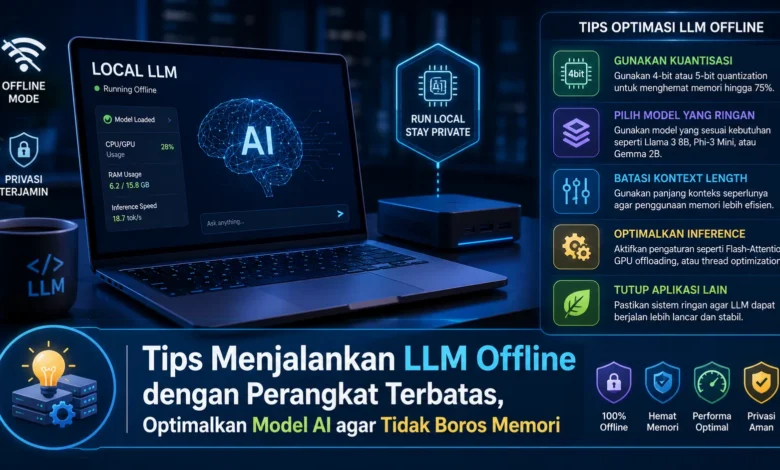
Menjalankan Large Language Model atau LLM secara offline kini tidak selalu membutuhkan komputer kelas workstation dengan RAM dan GPU berkapasitas besar. Laptop maupun PC dengan spesifikasi terbatas masih dapat digunakan selama model, format quantization, context window, dan runtime dipilih secara tepat. Dengan optimasi yang sesuai, TEKNOLOGI AI lokal dapat dimanfaatkan untuk menulis, merangkum, membantu pemrograman, atau memproses dokumen secara lebih privat tanpa membuat penggunaan RAM dan VRAM membengkak.
Model yang Tepat Menjadi Awal LLM Offline Lebih Ringan
Langkah pertama menjalankan LLM offline adalah mengetahui batas hardware komputer. Memori utama, kapasitas GPU, prosesor, dan kapasitas disk akan mempengaruhi model yang nyaman dijalankan. Memilih model terlalu besar dapat menyebabkan penggunaan memori melonjak, sehingga model kompak layak diprioritaskan pada perangkat terbatas.
Skala model memang memiliki pengaruh terhadap kemampuan model, tetapi model lebih besar tidak selalu menjadi pilihan terbaik untuk seluruh jenis pekerjaan. Model yang lebih kecil dan modern dapat memberikan hasil memadai pada pekerjaan ringan dengan beban hardware yang lebih ringan. Strategi pemilihan ini membuat TEKNOLOGI AI semakin terjangkau untuk eksperimen lokal.
Gunakan Quantization untuk Menekan Konsumsi Memori
Teknik pengurangan presisi menjadi strategi yang banyak digunakan untuk mengurangi kebutuhan memori LLM. Bobot yang telah dikuantisasi dapat membutuhkan ruang RAM lebih sedikit dibandingkan model dengan representasi parameter penuh. Efisiensi tersebut membuat quantization relevan untuk PC dengan spesifikasi terbatas yang tidak memiliki RAM besar.
Pemilihan tingkat quantization sebaiknya disesuaikan dengan kemampuan perangkat. Kompresi parameter yang semakin tinggi dapat mengurangi kebutuhan resource, tetapi dapat menurunkan akurasi pada kondisi tertentu. Untuk mendapatkan keseimbangan, pengguna dapat mencoba beberapa tingkat quantization hingga menemukan kombinasi yang nyaman. Strategi tersebut menjadi bagian penting TEKNOLOGI AI lokal.
Context Length yang Tepat Membantu Menghemat Memori
Context window sering diatur terlalu besar tanpa kebutuhan jelas, padahal konfigurasi tersebut dapat mempengaruhi penggunaan memori. Jika context length diperbesar, runtime perlu mengelola lebih banyak informasi selama inferensi. Dalam sistem dengan VRAM minim, penggunaan context window berlebihan dapat mengurangi ruang yang tersedia bagi proses lainnya.
Untuk pekerjaan yang tidak membutuhkan dokumen panjang, panjang konteks secukupnya biasanya lebih masuk akal. Panjang konteks sebaiknya disesuaikan berdasarkan tugas daripada mempertahankan konteks sangat panjang sepanjang waktu. Strategi sederhana tersebut dapat menjaga penggunaan memori lebih terkendali sekaligus membuat penggunaan model lebih efisien.
Seimbangkan Pemrosesan CPU dan GPU untuk Performa Lebih Efisien
Kartu grafis dapat mempercepat inferensi LLM apabila hardware memiliki dukungan yang diperlukan. Namun, kapasitas grafis yang tidak terlalu besar membuat offloading penuh sulit dilakukan. Pada perangkat seperti ini, pengguna dapat menggunakan konfigurasi offloading secara bertahap.
Proporsi pemrosesan grafis dapat dikurangi apabila memori GPU mulai penuh. Apabila memori grafis masih tersedia, porsi offloading dapat ditingkatkan. Sebaliknya, jika VRAM sangat terbatas, CPU dapat mengambil bagian lebih besar. Kemampuan membagi beban membuat TEKNOLOGI LLM offline dapat disesuaikan dengan beragam hardware.
Pilih Runtime Ringan dan Tutup Aplikasi yang Tidak Dibutuhkan
Selain ukuran model, software yang menjalankan model juga berperan dalam efisiensi memori. Aplikasi browser dengan banyak tab dapat menggunakan sebagian besar RAM. Ketika ingin menggunakan AI lokal, menutup aplikasi yang tidak diperlukan dapat membantu sistem bekerja lebih stabil.
Runtime yang efisien juga dapat membantu memanfaatkan hardware secara lebih baik. Konfigurasi GPU offloading, serta pemilihan model quantized dapat diatur mengikuti kebutuhan penggunaan. Konfigurasi maksimum belum tentu paling efisien. Tujuan yang lebih penting adalah mencari keseimbangan antara kecepatan, kualitas, dan memori.
Kesimpulan, LLM Offline Tetap Bisa Optimal pada Perangkat Terbatas
LLM lokal masih dapat dijalankan pada komputer dengan spesifikasi sederhana selama model dan konfigurasi dipilih secara tepat. Memilih model yang lebih kecil, menggunakan model terkuantisasi, menghindari context berlebihan, serta mengatur GPU offloading dapat mengurangi penggunaan memori.
Seiring TEKNOLOGI AI terus berkembang, model yang semakin efisien berpotensi memperluas penggunaan LLM offline. Dari pengalaman Anda, apakah LLM berukuran kecil dan efisien akan lebih banyak digunakan sehari hari? Bagikan pandangan Anda mengenai perkembangan TEKNOLOGI kecerdasan buatan dan ikuti pembahasan berikutnya untuk mengetahui cara memaksimalkan AI lokal.