Recursive Rilis Flint, Model AI Coding Terbuka yang Bisa Dijalankan Secara Lokal
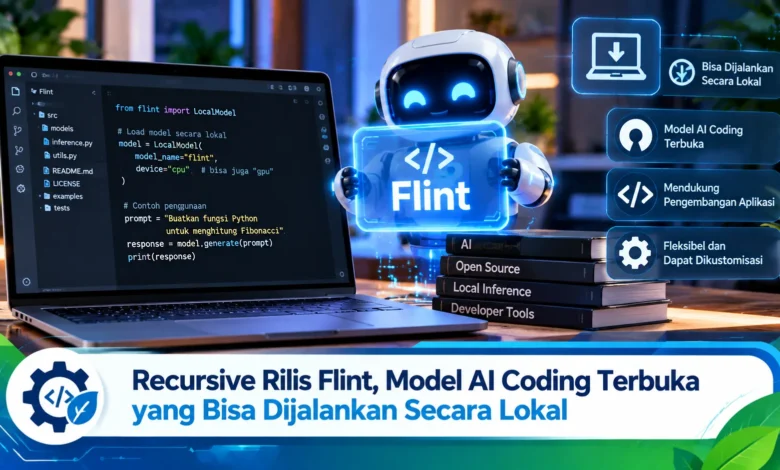
Perusahaan kecerdasan buatan Recursive memperkenalkan Flint pada 21 Oktober 2026 sebagai model AI coding terbuka yang dirancang untuk membantu pengembang menulis, memperbaiki, dan menguji kode secara lokal. Model ini menggunakan arsitektur Mixture-of-Experts dengan 39,8 miliar parameter, tetapi hanya mengaktifkan sekitar 2,5 miliar parameter untuk setiap token yang diproses. Pendekatan tersebut memungkinkan penggunaan komputasi yang lebih efisien dibandingkan model padat berukuran serupa. Dengan dukungan perangkat Apple Silicon dan GPU NVIDIA, Flint menawarkan alternatif bagi developer yang mengutamakan kecepatan, privasi, serta kontrol terhadap lingkungan pengembangan. Kehadirannya turut memperluas pilihan TEKNOLOGI AI coding yang dapat dijalankan tanpa selalu bergantung pada layanan cloud.
Mengenal Recursive Flint sebagai Model AI Coding Terbuka
Flint dikembangkan oleh Recursive sebagai model bahasa khusus untuk pekerjaan pemrograman. Berbeda dari chatbot yang mengutamakan percakapan umum, Flint dioptimalkan bagi tugas pengembangan kode. Penggunaan model ini mencakup pemeriksaan repository, penanganan kesalahan program, implementasi fitur, dan penyusunan kode pengujian. Dengan pendekatan ini, tim perangkat lunak memiliki alternatif untuk mempercepat pekerjaan. Namun demikian, hasil model tetap membutuhkan pemeriksaan manusia. Prinsip pengawasan ini membantu mengurangi kemungkinan kesalahan.
Keunggulan penting model Recursive ini adalah penggunaan lisensi terbuka untuk model. Recursive merilis Flint dengan lisensi Apache 2.0 yang memungkinkan integrasi dalam proyek yang sesuai ketentuan lisensi. Berkat akses terhadap bobot model, pemrosesan AI tidak harus selalu dilakukan pada server pihak ketiga. Pendekatan penggunaan lokal bermanfaat bagi tim yang ingin mengatur lingkungan komputasi sendiri. Walaupun bobot tersedia secara terbuka, penggunaan Flint tetap memerlukan perangkat keras yang sesuai. Selain itu, integrasi agen perlu dikelola secara aman. Berkat pemahaman tersebut, manfaat AI lokal dapat diperoleh secara lebih optimal.
Teknologi Model AI 40 Miliar Parameter yang Efisien
Flint menggunakan Mixture-of-Experts atau MoE yang mengaktifkan komponen tertentu sesuai kebutuhan pemrosesan. Dalam konfigurasi lengkapnya, Flint menggunakan total parameter mendekati 40 miliar. Namun, jumlah parameter yang digunakan per token sekitar 2,5 miliar. Karakteristik arsitektur ini menjadi alasan penting di balik efisiensi model. Berbeda dari pendekatan MoE, seluruh lapisan utama digunakan secara lebih menyeluruh. Sebaliknya, pemrosesan diarahkan menuju bagian jaringan yang diperlukan. Berkat pemilihan komponen yang selektif, inferensi menjadi lebih efisien pada perangkat yang mendukung.
Selain arsitektur MoE, Flint menyediakan jendela konteks sekitar 262 ribu token. Ukuran konteks ini memungkinkan model menerima kode dan instruksi panjang. Sebagai contoh, informasi dokumentasi proyek dapat disertakan bersama kode. Meski ruang informasi tersedia luas, model belum tentu menganalisis seluruh informasi dengan kualitas sama. Untuk menjaga efektivitas, tugas sebaiknya dipecah menjadi bagian yang jelas. Selain itu, informasi yang tidak relevan sebaiknya dibatasi. Pengelolaan konteks yang tepat membantu meningkatkan kualitas hasil.
Kecepatan Flint pada Apple Silicon dan GPU NVIDIA
Recursive mengembangkan berbagai konfigurasi inferensi agar Flint mampu berjalan pada GPU NVIDIA yang kompatibel. Dalam evaluasi performa perusahaan, Flint mencapai kecepatan di atas 125 token per detik pada perangkat M4 Pro. Pada perangkat NVIDIA tertentu, hasil inferensi disebut melampaui 150 token per detik pada sistem komputasi yang digunakan perusahaan. Angka performa ini menjadi salah satu daya tarik pendekatan MoE. Meski hasilnya menarik, hasil dapat berubah menurut jumlah token konteks. Dalam penggunaan nyata, pengembang sebaiknya membandingkan hasil pada perangkat masing-masing.
Untuk mempermudah penggunaan, Flint tersedia dalam sejumlah konfigurasi inferensi. Konfigurasi model yang tersedia adalah BF16 yang digunakan sebagai checkpoint dasar. Untuk mengurangi kebutuhan memori, Recursive menyediakan checkpoint quantization seperti NVFP4 dan GGUF. Format tersebut membantu memungkinkan inferensi pada perangkat yang lebih terbatas. Walaupun quantization membantu efisiensi, penggunaan RAM dan VRAM dapat meningkat saat konteks panjang. Untuk memilih konfigurasi yang sesuai, spesifikasi perangkat keras sebaiknya dibandingkan dengan kebutuhan runtime. Melalui pemilihan versi yang tepat, pengembang dapat menghindari konfigurasi yang terlalu membebani komputer.
Langkah Awal Mengintegrasikan Model Flint ke Alur Kerja Coding
Salah satu cara praktis untuk menggunakan Flint pada komputer sendiri adalah menggunakan aplikasi Ollama. Dalam ekosistem model AI lokal, Ollama menjadi runtime yang mempermudah pengelolaan model lokal. Sesudah lingkungan lokal dipersiapkan, pengguna dapat membuka terminal. Penggunaan sintaks ollama run flint mengaktifkan model setelah proses pengunduhan yang diperlukan. Setelah runtime berhasil menjalankan checkpoint, developer bisa mengajukan pertanyaan tentang kode. Walaupun langkah dasarnya sederhana, fungsi pengeditan file bergantung pada integrasi tools yang digunakan.
Di luar penggunaan runtime tersebut, Flint juga mendukung beberapa ekosistem inferensi. Pilihan tersebut mencakup vLLM, LM Studio, dan perangkat lunak inferensi lainnya. Untuk pengguna perangkat Apple, Recursive menghadirkan perangkat lunak rec untuk menjalankan Flint. Runtime tersebut memanfaatkan optimalisasi bagi prosesor Apple yang kompatibel. Pada integrasi dengan asisten pemrograman, Flint dapat dipadukan dengan OpenHands. Dengan integrasi tersebut, pekerjaan coding dapat diperluas dari percakapan menjadi tindakan terstruktur. Walaupun integrasi tersebut bermanfaat, perintah otomatis sebaiknya dijalankan dalam lingkungan aman. Pengawasan tersebut penting untuk mencegah perubahan kode yang tidak diharapkan.
Benchmark Recursive Flint dalam Tugas Agentic Coding
Flint dioptimalkan untuk membantu aktivitas rekayasa perangkat lunak yang kompleks. Dalam skenario pengembangan, agen dapat diarahkan memeriksa penyebab masalah aplikasi. Model kemudian meninjau bagian kode yang relevan sebelum hasil perubahan diperiksa melalui test. Di luar kegiatan debugging, Flint mendukung penyusunan fungsi baru serta membuat unit test. Kemampuan tersebut mendukung produktivitas pengembang. Meskipun AI mampu menghasilkan kode, solusi tidak boleh langsung dianggap benar. Proses validasi ini membantu menjaga keandalan perangkat lunak.
Dalam pengujian performa model, Recursive melaporkan pencapaian pada pengujian agentic coding. Pada Terminal-Bench 2.1, Flint mencapai tingkat keberhasilan 54,9 persen. Dalam pengujian perbaikan perangkat lunak, hasil SWE-bench Pro v2 mencapai 89,7 persen, sedangkan SWE-bench Verified mencapai 74,2 persen. Angka evaluasi tersebut perlu dibaca sebagai hasil yang dipublikasikan perusahaan. Untuk melakukan perbandingan yang tepat, perbedaan lingkungan benchmark dapat memengaruhi angka. Selain itu, hasil benchmark tidak menjamin semua tugas selesai dengan benar. Berdasarkan keterbatasan evaluasi, pengujian langsung tetap diperlukan.
Penutup: Peluang Model AI Terbuka dalam Pengembangan Perangkat Lunak
Rilis model terbuka dari Recursive menunjukkan kemajuan pemanfaatan AI untuk pemrograman. Melalui penggunaan sekitar 2,5 miliar parameter aktif, Flint dirancang memberikan inferensi cepat. Kapasitas hingga 262 ribu token serta pilihan menjalankan model pada perangkat sendiri mendukung berbagai kebutuhan pemrograman. Sebagai keunggulan penting, dukungan ekosistem open-weight memungkinkan adopsi yang lebih fleksibel. Walaupun demikian, pengawasan manusia tetap diperlukan. Seiring kemajuan TEKNOLOGI pemrograman, penggunaan kecerdasan buatan pada perangkat sendiri semakin relevan. Bagaimana pandangan Anda, apakah Flint menarik untuk membantu pekerjaan pemrograman sehari-hari? Bagikan pandangan Anda tentang masa depan model pemrograman terbuka.