Cara Kerja AI Inference Engine Optimization dalam Meningkatkan Performa CPU, GPU, dan NPU
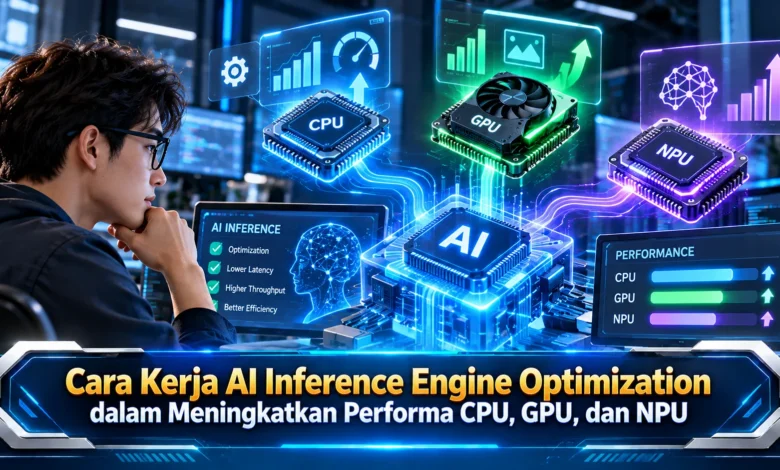
AI Inference Engine Optimization menjadi semakin penting ketika kecerdasan buatan mulai dijalankan langsung pada smartphone, laptop, komputer, kendaraan, dan berbagai perangkat edge. Teknologi ini membantu mengatur bagaimana model AI menggunakan CPU, GPU, NPU, memori, serta sumber daya sistem agar proses inference berlangsung lebih cepat dan efisien. Dengan optimalisasi yang tepat, perangkat dapat menjalankan fitur AI secara responsif tanpa hanya mengandalkan peningkatan kekuatan hardware.
Mengenal Cara Kerja AI Inference Engine Optimization
AI Inference Engine Optimization dapat dipahami sebagai proses untuk membuat model AI menggunakan sumber daya perangkat secara lebih efisien ketika menjalankan inference. Ketika model menerima data baru, mesin inference membantu mengelola operasi yang diperlukan agar proses menghasilkan keluaran berlangsung secara optimal. Optimalisasi dibutuhkan karena model kecerdasan buatan modern dapat melibatkan banyak perhitungan sekaligus perpindahan informasi yang intensif.
Inference engine kemudian dapat melakukan berbagai optimalisasi pada struktur komputasi sebelum maupun selama model dijalankan. Beberapa operasi dapat digabungkan, proses yang tidak memberikan manfaat dapat diminimalkan, sementara beban kerja diarahkan ke unit komputasi yang tepat. Cara tersebut menunjukkan bahwa teknologi inference tidak semata mata ditentukan oleh kekuatan prosesor, melainkan juga kemampuan software mengoptimalkan perangkat keras.
Optimalisasi AI Memanfaatkan CPU GPU serta NPU secara Bersamaan
Setiap CPU, GPU, dan NPU mempunyai karakteristik tersendiri sehingga jenis workload yang cocok untuk masing masing unit dapat berbeda. CPU bersifat serbaguna untuk berbagai pekerjaan, sementara GPU menawarkan kemampuan komputasi paralel yang kuat. NPU dirancang untuk mempercepat sejumlah workload AI dengan penggunaan sumber daya yang lebih terarah.
Inference engine dapat memanfaatkan perbedaan tersebut dengan menempatkan operasi pada unit komputasi yang paling sesuai. Operasi umum serta logika sistem dapat ditangani CPU, workload paralel dapat memanfaatkan GPU, sedangkan operasi AI yang didukung dapat diarahkan menuju NPU. Dengan pembagian yang efisien, teknologi AI dapat memanfaatkan berbagai unit komputasi sehingga proses inference tidak hanya bergantung pada satu jenis hardware.
Inference Engine Mengoptimalkan Alur Komputasi sebelum Dijalankan
Model AI dapat direpresentasikan sebagai rangkaian operasi komputasi yang saling berhubungan dan membentuk sebuah computational graph. Mesin inference dapat memeriksa struktur tersebut untuk menentukan operasi yang dapat dioptimalkan atau dijalankan secara lebih efektif. Optimalisasi tersebut bertujuan menekan proses tambahan sambil mempertahankan fungsi model.
Operator fusion menjadi salah satu pendekatan yang dapat digunakan untuk menggabungkan beberapa operasi yang sebelumnya diproses secara terpisah. Cara ini dapat menekan perpindahan data yang berulang antara prosesor dan sistem memori. Dengan mengurangi proses tambahan, unit CPU, GPU, serta NPU dapat menjalankan workload utama secara lebih efektif. Pendekatan tersebut membuat teknologi inference dapat menghasilkan efisiensi tambahan tanpa harus selalu meningkatkan kemampuan fisik hardware.
Quantization Mengurangi Beban Model pada Hardware
Quantization merupakan salah satu teknik penting dalam optimalisasi inference karena model AI biasanya menggunakan banyak nilai numerik selama proses komputasi. Dengan menggunakan representasi numerik yang lebih ringkas pada bagian yang sesuai, kebutuhan memori dan komputasi dapat dikurangi. Model yang lebih ringan dapat dipindahkan melalui sistem memori dengan lebih efisien sehingga bandwidth tidak terlalu terbebani.
Efisiensi quantization dapat menjadi lebih besar ketika unit komputasi mendukung format data yang telah dioptimalkan. Perangkat NPU dapat memiliki dukungan khusus terhadap operasi AI tertentu, sedangkan GPU dan CPU juga dapat menyediakan instruksi untuk mempercepat pemrosesan numerik. Namun, tingkat quantization perlu diuji karena pengurangan presisi yang terlalu agresif dapat memengaruhi kualitas hasil model. Dengan demikian, teknologi optimalisasi perlu mempertimbangkan kecepatan eksekusi, efisiensi sumber daya, penggunaan energi, dan mutu hasil secara bersamaan.
Pengelolaan Data Membantu Hardware AI Bekerja Lebih Optimal
Performa inference tidak hanya ditentukan oleh kemampuan CPU, GPU, atau NPU melakukan operasi matematika. Parameter dan informasi model harus bergerak antara sistem memori dengan prosesor sehingga perpindahan tersebut dapat membatasi performa jika berlangsung kurang efisien. Prosesor yang kuat belum tentu mencapai kemampuan maksimal apabila aliran data menuju hardware menjadi hambatan.
Mesin inference dapat mengatur penggunaan memori serta urutan pekerjaan agar unit komputasi tidak terlalu sering menunggu data. Buffer dapat digunakan kembali, alokasi memori dapat direncanakan, dan urutan operasi dapat diatur agar perpindahan data menjadi lebih efisien. Jika perangkat menyediakan CPU, GPU, serta NPU, sistem juga perlu menghitung overhead ketika pekerjaan berpindah dari satu accelerator menuju accelerator lain. Pendekatan ini membuat teknologi AI dapat memanfaatkan perangkat keras secara lebih efisien sambil mengontrol waktu respons dan kebutuhan energi.
Optimalisasi Inference Membuat CPU GPU dan NPU Bekerja Lebih Efektif
AI Inference Engine Optimization bekerja dengan menghubungkan kemampuan software dan hardware agar model AI dapat dijalankan secara lebih efisien. CPU berperan sebagai unit komputasi serbaguna, GPU unggul dalam pemrosesan paralel, sementara NPU memberikan kemampuan khusus untuk mempercepat operasi AI tertentu. Sistem inference menentukan penempatan workload dengan mempertimbangkan karakteristik operasi dan kemampuan masing masing prosesor. Teknik seperti graph optimization, operator fusion, quantization, pengelolaan memori, dan penjadwalan workload kemudian membantu mengurangi overhead serta meningkatkan pemanfaatan sumber daya. Dengan integrasi yang tepat, teknologi AI dapat memperoleh waktu respons lebih singkat, penggunaan memori lebih efisien, serta konsumsi daya yang lebih terkontrol tanpa sekadar menambah kekuatan hardware. Pembaca dapat terus mengikuti perkembangan AI Inference Engine Optimization dan berbagi pandangan mengenai peran CPU, GPU, serta NPU dalam menghadirkan perangkat AI yang semakin cepat dan responsif.


