Tips Mengoptimalkan GPU untuk AI Generatif, Hindari Bottleneck Saat Menjalankan Model Besar
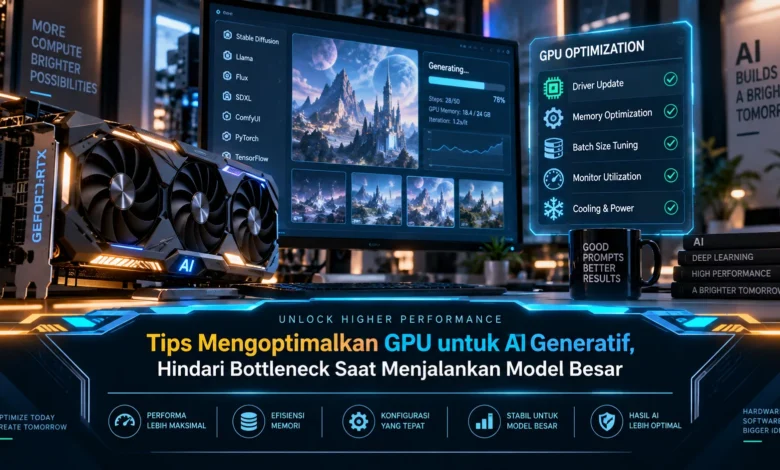
AI generatif membutuhkan sumber daya komputasi yang cukup besar, terutama ketika pengguna mulai menjalankan model dengan jumlah parameter tinggi, context panjang, atau proses generasi yang kompleks. GPU yang kuat memang membantu, tetapi performa tetap dapat terhambat jika VRAM, CPU, RAM, storage, dan konfigurasi software tidak bekerja secara seimbang. Memahami cara mengoptimalkan GPU menjadi bagian penting dalam perkembangan TEKNOLOGI AI agar model besar dapat berjalan lebih cepat, stabil, dan efisien tanpa membebani sistem secara berlebihan.
Kenali Komponen yang Membatasi Performa AI Generatif
Langkah pertama dalam mengoptimalkan GPU untuk AI generatif ialah memahami bagian sistem yang membatasi kecepatan komputasi. Akselerator grafis menangani sebagian besar operasi berat pada banyak workload AI, tetapi performa keseluruhan tidak hanya bergantung pada kemampuan GPU. Prosesor, memory sistem, penyimpanan, kapasitas VRAM, bandwidth, dan software dapat menjadi faktor yang menentukan efisiensi workload.
Mengamati utilisasi hardware merupakan langkah efektif untuk mengetahui sumber masalah. Jika penggunaan GPU rendah sementara CPU terus bekerja tinggi, workload kemungkinan belum memanfaatkan akselerasi GPU secara optimal. Ketika kapasitas VRAM hampir seluruhnya digunakan, ukuran model, context, cache, atau precision perlu diperiksa. Pendekatan berbasis data tersebut dapat membuat proses peningkatan performa TEKNOLOGI AI lebih efektif.
Atur Penggunaan VRAM Sebelum Menjalankan Model Besar
VRAM menjadi salah satu faktor terpenting ketika menjalankan model AI generatif berukuran besar. Data model harus ditempatkan pada memory yang tersedia, sementara proses inferensi menghasilkan kebutuhan memory tambahan. Karena kondisi tersebut, model yang terlihat dapat dimuat belum tentu memiliki ruang cukup untuk bekerja secara optimal.
Memberikan ruang VRAM cadangan dapat membantu sistem menghadapi perubahan kebutuhan memory. Aplikasi lain yang menggunakan GPU juga sebaiknya diperhatikan. Peramban dengan banyak tab, perangkat lunak kreatif, permainan, serta aplikasi multimedia dapat menggunakan ruang yang sebenarnya dibutuhkan workload AI. Melalui manajemen memory yang lebih disiplin, AI generatif dapat memanfaatkan kemampuan GPU secara lebih optimal.
Model AI Generatif Bisa Lebih Ringan dengan Quantization
Pengurangan precision merupakan salah satu strategi populer dalam menekan konsumsi VRAM AI generatif. Bobot model dalam format dengan precision tinggi dapat memberikan tekanan lebih tinggi pada memory GPU. Dengan mengurangi jumlah bit pada bobot tertentu, konsumsi memory dapat berkurang sehingga model lebih mudah dijalankan pada perangkat yang tersedia.
Pemilihan quantization tetap perlu mempertimbangkan kualitas. Konfigurasi yang semakin agresif dapat menghemat lebih banyak VRAM, namun konsistensi output tertentu mungkin mengalami perubahan. Karena itu, beberapa konfigurasi sebaiknya dibandingkan menggunakan workload yang sama. Pendekatan terbaik adalah mencari kombinasi antara performa model, hasil generasi, dan penggunaan memory.
Batch dan Context Menentukan Efisiensi Inferensi
Ukuran model bukan satu satunya penyebab tingginya konsumsi VRAM. Jumlah token yang diproses juga dapat meningkatkan kebutuhan memory karena sistem perlu mempertahankan informasi tertentu selama proses inferensi. Menggunakan context maksimum untuk setiap pekerjaan berpotensi menggunakan memory tanpa memberikan manfaat yang sebanding.
Konfigurasi batch harus mempertimbangkan kebutuhan model dan GPU. Batch yang lebih besar dapat meningkatkan throughput dalam kondisi tertentu, meski tekanan terhadap memory dapat menjadi lebih besar. Pengaturan awal sebaiknya menggunakan beban yang aman, selanjutnya disesuaikan sambil memperhatikan throughput dan penggunaan VRAM. Strategi bertahap tersebut membuat pengguna lebih mudah menemukan titik optimal.
Optimalkan GPU Offloading dan Jalur Transfer Data
AI generatif yang membutuhkan memory melebihi kapasitas GPU dapat membutuhkan offloading sebagian komponen ke CPU atau RAM. Offloading dapat membuat workload yang lebih besar tetap dapat diproses, meski komunikasi antara GPU dan sistem utama dapat membatasi performa. Semakin besar kebutuhan transfer antara CPU dan GPU, semakin tinggi potensi munculnya hambatan.
Ketika terdapat ruang tambahan pada kartu grafis, porsi komputasi GPU dapat ditingkatkan. Pendekatan ini dapat menekan kebutuhan transfer ke memory sistem. Namun jika VRAM terbatas, pembagian workload perlu disesuaikan secara hati hati. Keseimbangan antara kapasitas dan kecepatan menjadi bagian penting dalam menghindari bottleneck.
Framework yang Tepat Bisa Meningkatkan Performa Model
Hardware yang kuat belum tentu menghasilkan performa terbaik. Driver grafis, framework machine learning, backend pemrosesan, serta konfigurasi inferensi dapat memberikan pengaruh terhadap kecepatan dan stabilitas. Memastikan seluruh komponen software bekerja dengan konfigurasi yang sesuai dapat mencegah sebagian hambatan yang sebenarnya berasal dari software.
Pemantauan perlu dijalankan selama workload AI aktif. Pemakaian GPU, kapasitas VRAM, aktivitas CPU, memory sistem, temperatur, serta kecepatan inferensi dapat memberikan gambaran mengenai kondisi sistem. Melalui pencatatan hasil dari setiap konfigurasi, pengguna dapat mengetahui optimasi mana yang benar benar memberikan peningkatan. Pendekatan monitoring ini membantu mengoptimalkan TEKNOLOGI AI berdasarkan kondisi perangkat yang sebenarnya.
Penutup
Mengoptimalkan GPU untuk AI generatif membutuhkan pendekatan menyeluruh karena bottleneck dapat berasal dari banyak bagian sistem. Kapasitas VRAM, model, tingkat precision, context, batch size, CPU, RAM, media penyimpanan, offloading, serta runtime perlu bekerja dalam konfigurasi yang seimbang. Dengan mengatur setiap komponen secara terukur, AI generatif dapat memperoleh performa lebih baik tanpa memberikan tekanan berlebihan pada sistem.
Evaluasi performa perlu dilakukan setiap kali konfigurasi diubah. Perkembangan TEKNOLOGI generative AI membuat kebutuhan komputasi terus berubah, sehingga tidak ada satu konfigurasi yang selalu ideal untuk semua perangkat. Dengan memantau sumber daya dan membandingkan hasil setiap perubahan, pengguna dapat memperoleh kombinasi kecepatan, kualitas, dan efisiensi yang lebih baik. Pengguna dapat membandingkan beberapa konfigurasi untuk menemukan pengaturan paling sesuai dengan workload masing masing.